PRODUK MTP
MATA
Model-Agnostic Task Architecture — kerangka kerja fleksibel untuk membangun solusi AI Vision.
Tulis pipeline vision Anda sekali. Tukar model apa pun — HuggingFace, ONNX, Torchvision — tanpa mengubah satu baris kode.
Apa Itu MATA?
MATA (Model-Agnostic Task Architecture) adalah framework Python sumber terbuka untuk computer vision: tulis satu tugas sekali — deteksi, segmentasi, klasifikasi, pelacakan, pembacaan teks, penalaran dengan vision-language model — lalu tukar model dasarnya tanpa menyentuh pipeline Anda.
01
Pemuatan Model Universal
Muat model berdasarkan ID HuggingFace, file ONNX lokal, arsip TorchScript, nama Torchvision, atau alias konfigurasi dengan satu panggilan. Universal loader mendeteksi runtime secara otomatis dan menyiapkan adapter yang tepat.
02
Pipeline Graf yang Dapat Dikomposisi
Rangkai Detect → Filter → PromptBoxes → Fuse ke dalam graf asiklik berarah yang diketik, dengan eksekusi paralel, percabangan kondisional, dan alur kontrol — tugas independen berjalan bersamaan untuk percepatan 1,5–3×.
03
Zero-Shot untuk Semua
CLIP untuk klasifikasi, GroundingDINO untuk deteksi, SAM untuk segmentasi — tanpa data pelatihan. Deskripsikan yang Anda inginkan dalam bahasa alami dan hasilnya langsung muncul pada percobaan pertama.
Kemampuan Inti
Seluruh tugas di balik satu API tiga baris yang konsisten — ditambah pengenalan galeri, pencarian video berbahasa alami, dan perangkat validasi.
01
Deteksi Objek
Bounding box dan skor keyakinan dengan DETR, RT-DETR, GroundingDINO, OWL-ViT, RetinaNet, Faster R-CNN, FCOS, SSD, serta varian YOLO.
02
Segmentasi
Segmentasi instance, panoptik, dan semantik dengan Mask2Former, MaskFormer, serta SAM/SAM3 — termasuk segmentasi promptable zero-shot melalui titik, kotak, atau teks.
03
Klasifikasi
Klasifikasi gambar standar maupun zero-shot dengan ResNet, ViT, ConvNeXt, EfficientNet, Swin, dan klasifier HuggingFace apa pun.
04
Estimasi Kedalaman
Kedalaman monokular dengan Depth Anything V1/V2 — peta kedalaman per piksel dari satu gambar, dapat diekspor sebagai render berwarna.
05
Pelacakan Objek
Pelacakan multi-objek dengan ByteTrack dan BotSort — sepenuhnya vendored, tanpa dependensi eksternal — plus ReID penampilan dan streaming hemat memori untuk RTSP atau video panjang.
06
OCR
Ekstraksi teks melalui EasyOCR, PaddleOCR, Tesseract, TrOCR, GOT-OCR2, dan GLM-OCR, lengkap dengan bounding box dan penanganan tata letak dokumen.
07
Vision-Language Model
Captioning, visual question answering, dan agen pemanggil alat dengan Qwen3-VL, Gemma 4, Florence-2, LLaVA-NeXT, SmolVLM, Moondream2, dan MedGemma.
08
Embedding Fitur
Vektor fitur gambar untuk pencarian kemiripan, pencocokan galeri, dan pipeline pengenalan dengan CLIP, OSNet, dan X-CLIP.
09
Pengenalan
Daftarkan galeri gambar sekali, lalu cocokkan wajah, orang, atau objek berdasarkan kemiripan embedding — satu perintah, tanpa tahap pelatihan.
10
Barcode & QR
Membaca barcode dan QR dari gambar menggunakan pyzbar atau zxing-cpp — terintegrasi sebagai tugas kelas satu.
11
Indeks & Pencarian Video
Indeks video berdasarkan embedding per frame, lalu kueri dengan bahasa alami — "pesepeda menyerobot di antara lalu lintas cepat pada malam hari" mengembalikan stempel waktu berperingkat.
12
Validasi & Metrik
Menilai model deteksi, klasifikasi, dan kedalaman terhadap COCO, ImageNet, dan DIODE dengan metrik standar seperti mAP, langsung dari CLI.
Pipeline Graf
Pembeda utama MATA adalah sistem graf tugas yang diketik. Susun tugas menjadi DAG tervalidasi yang berjalan paralel bila memungkinkan — tanpa orkestrasi manual.
DAG yang Diketik
Setiap node menyatakan tipe artefak masuk dan keluarnya, sehingga validator menangkap kesalahan penyambungan sebelum runtime — tidak ada lagi ketidaksesuaian bentuk saat inferensi.
Eksekusi Paralel
Tugas independen — Detect + Classify + Depth — berjalan bersamaan. Penjadwal menyelesaikan dependensi dan menggabungkan hasil secara deterministik, untuk percepatan 1,5–3×.
Alur Kontrol Kondisional
Bercabang berdasarkan keyakinan deteksi, lewati frame kosong, atau ulangi hingga ambang mutu terpenuhi, dengan primitif EarlyExit dan While.
DSL Mnemonik
Graf terbaca seperti kalimat: Detect → Filter → PromptBoxes → RefineMask → Fuse. Gaya pipa maupun penyambungan eksplisit menghasilkan DAG tervalidasi yang sama.
Preset Bawaan
Alur kerja umum sudah siap dijalankan — grounding_dino_sam dan full_scene_analysis — sehingga tim memulai dari pipeline yang bekerja, bukan dari berkas kosong.
Koordinasi Berbasis Valkey
Integrasi Valkey/Redis opsional untuk caching, state bersama, dan pub/sub pada beban kerja graf yang panjang atau terdistribusi.
Skenario Terdokumentasi
Dua puluh pipeline siap dijalankan di enam industri, masing-masing menggabungkan beberapa tugas vision dan diterbitkan bersama kodenya dalam panduan Real-World Scenarios.
Manufaktur
Empat skenario — deteksi dan klasifikasi cacat permukaan, segmentasi cacat dengan pengukuran area, verifikasi perakitan dengan VLM, dan inspeksi per komponen.
Retail
Tiga skenario — analisis produk di rak, pencarian produk zero-shot, dan penilaian stok multimoda.
Kendaraan Otonom
Empat skenario — estimasi jarak kendaraan, analisis skena jalan menyeluruh, pelacakan objek lalu lintas, dan deteksi hambatan dengan penalaran VLM.
Keamanan & Pengawasan
Tiga skenario — pemantauan dan pelacakan kerumunan, deteksi objek mencurigakan, dan pemantauan kesadaran situasional.
Pertanian
Tiga skenario — klasifikasi penyakit tanaman, segmentasi lahan pertanian dari udara, dan deteksi hama beserta pemetaannya.
Kesehatan
Tiga skenario — segmentasi ROI medis, penyusunan laporan berbantuan VLM, dan alur triase patologi.
Sumber Terbuka
MATA berlisensi Apache 2.0 dan dipasang dari PyPI dengan satu perintah: pip install datamata. Ia hadir dengan CLI, helper notebook, katalog model terkurasi, dan lebih dari 5.500 pengujian yang lulus di seluruh keluarga tugas di atas. Python 3.10 atau lebih baru, CPU secara bawaan dan CUDA bila tersedia. Framework ini sengaja bersifat model-agnostik dan berfokus pada inferensi — perkakas pelatihan dan ekspor ONNX terkuantisasi menyusul di v2.0, sehingga saat ini MATA adalah pilihan tepat untuk membangun, menyusun, dan memvalidasi pipeline vision, bukan untuk melatih model dari nol.
Terbaru dari MATA
Fitur baru, rilis, dan tulisan dari platform ini.
NEW FEATURE
Pemuatan Model Universal
Muat model apa pun lewat ID HuggingFace, berkas ONNX atau TorchScript lokal, nama Torchvision, atau alias konfigurasi — loader mendeteksi runtime-nya dan pipeline di atasnya tetap tidak berubah.
NEW FEATURE
Pipeline Graf yang Diketik
Susun tugas menjadi DAG bertipe yang divalidasi sebelum berjalan dan menjalankan pekerjaan independen secara paralel, lengkap dengan alur kontrol, preset, dan asal-usul hasil.
NEW FEATURE
Vision Zero-Shot
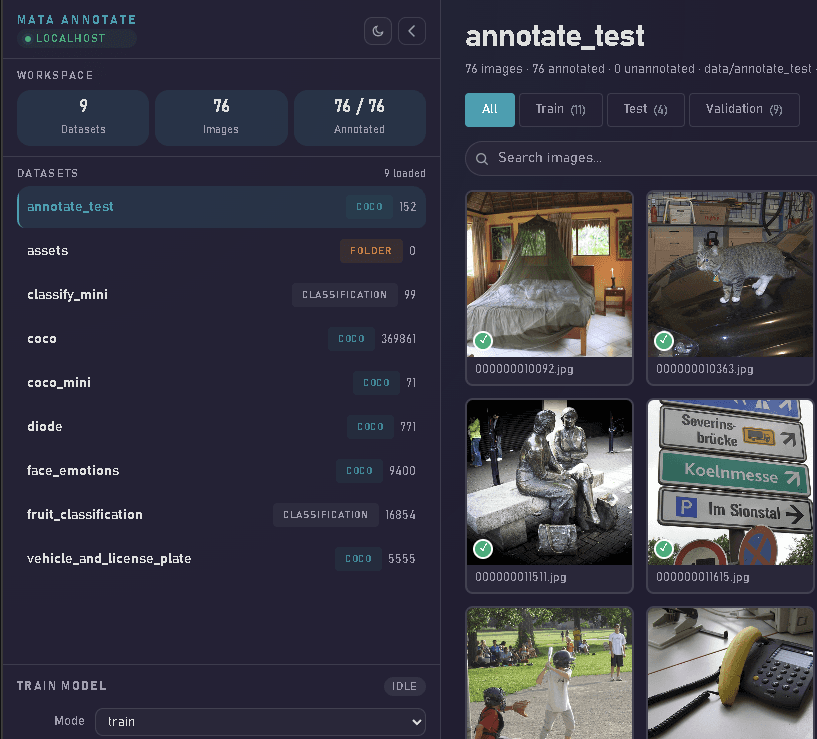
Klasifikasi CLIP, deteksi GroundingDINO, dan segmentasi SAM dari prompt teks maupun titik — tanpa data pelatihan untuk memperoleh hasil pertama.
NEW FEATURE
Indeks dan Pencarian Video
Indeks rekaman berdasarkan embedding per frame lalu tanyai dengan bahasa alami; kecocokan kembali berperingkat beserta stempel waktunya.
Tertarik dengan MATA?
Integrasikan MATA ke lingkungan operasional Anda, atau pasang hari ini dan jalankan deteksi pertama dalam waktu kurang dari satu menit — kami siap memandu tim Anda.